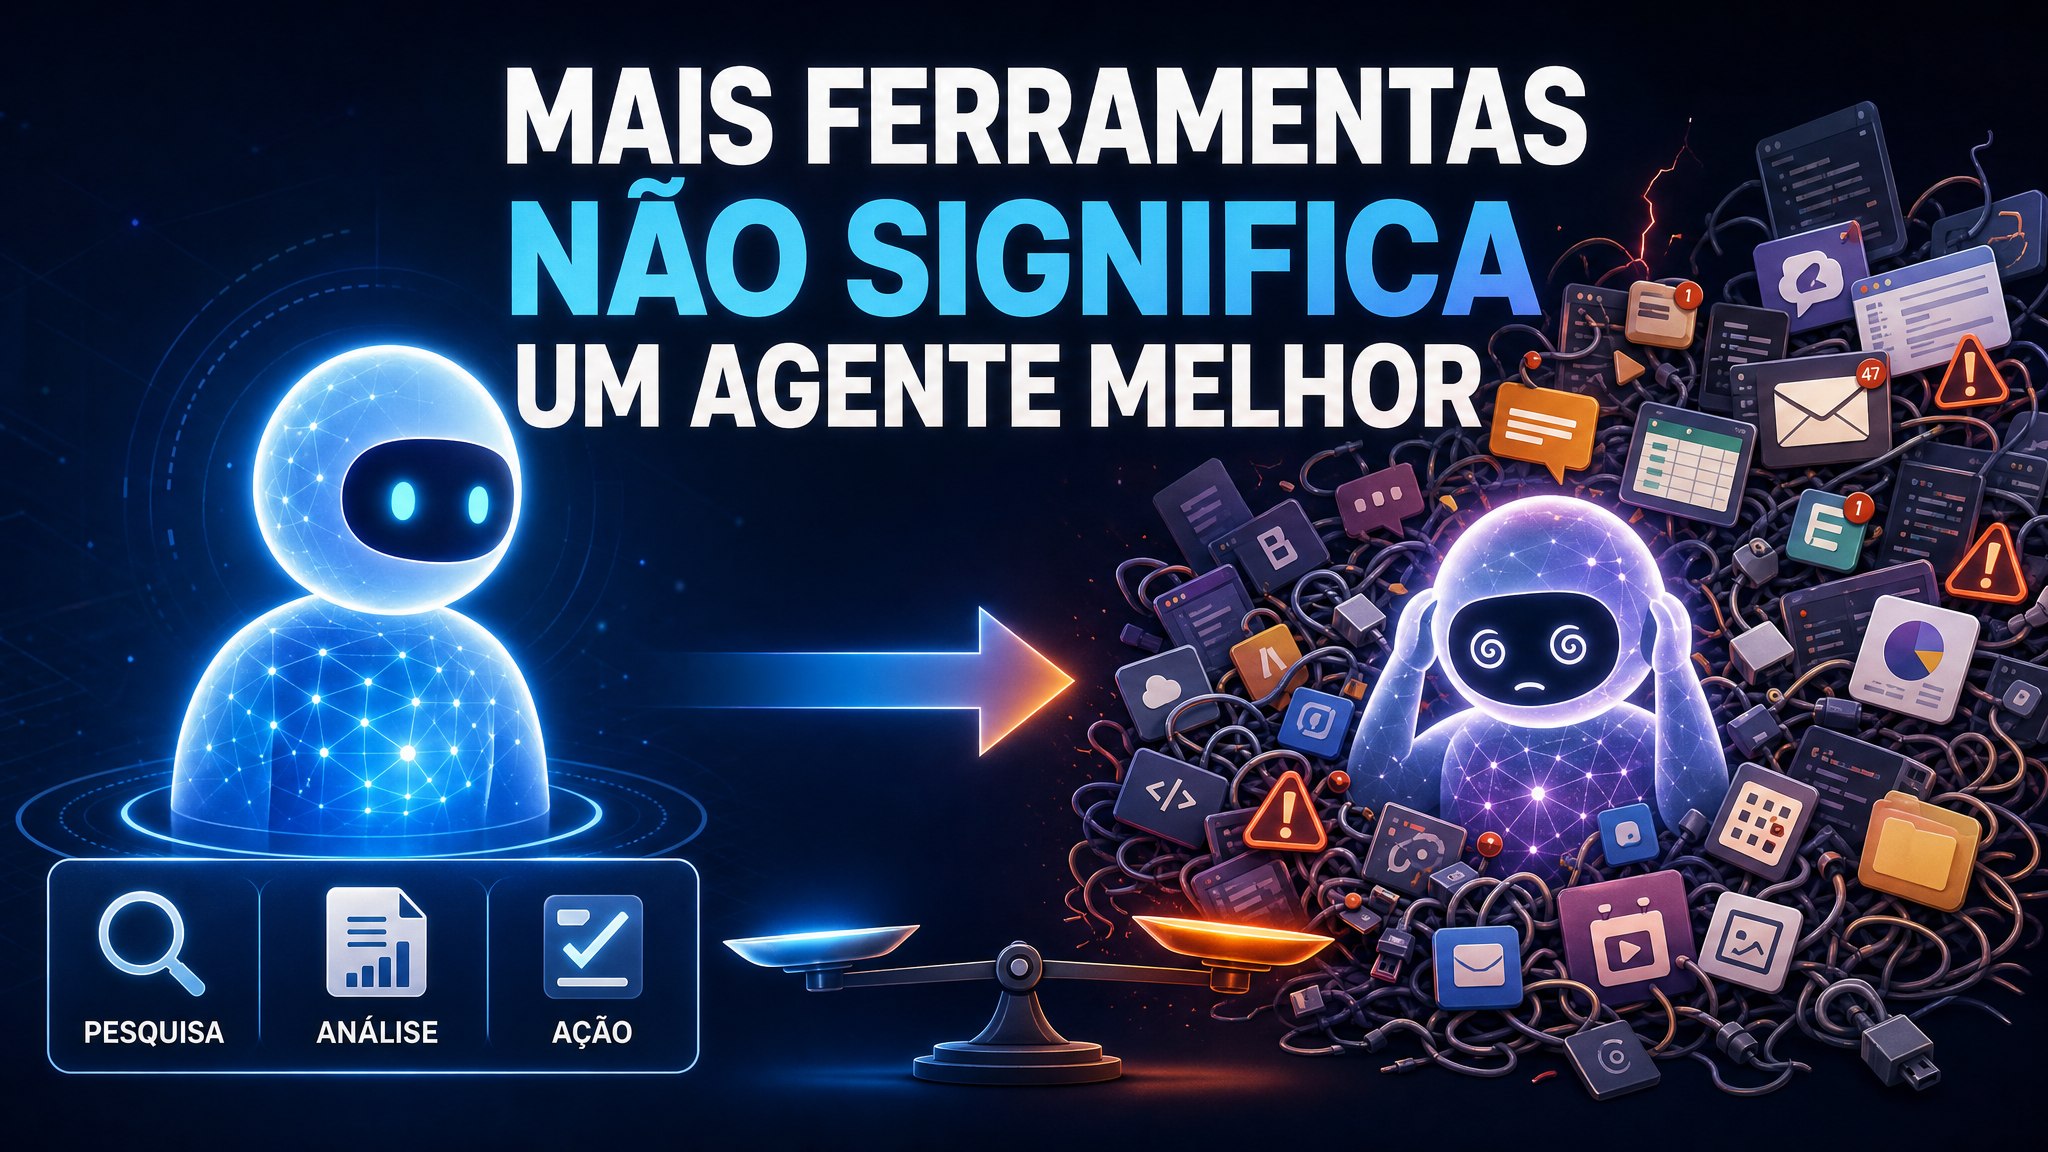

Existe uma tentação comum na construção de agentes de IA: sempre que algo dá errado, adicionar mais uma ferramenta.
- Uma busca na web
- Mais um banco de dados
- Um novo prompt
- Uma integração extra
- Mais contexto
- Mais automações.
A lógica parece simples: se o agente tem mais recursos, ele deveria ser capaz de fazer mais. Mas, na prática, o excesso de ferramentas pode tornar o agente mais confuso, lento e inconsistente.
O que realmente é um agente?
Um agente de IA pode ser entendido como a combinação de duas partes:
- O modelo, que decide o que fazer.
- As ferramentas e o contexto, que permitem executar a decisão.
É parecido com contratar um estagiário engenheiro júnior. O modelo é o engenheiro. As ferramentas são o computador, a documentação, os acessos, os sistemas internos e os instrumentos de trabalho.
Entregar um ambiente completo pode ajudar. Mas entregar ferramentas demais, sem organização ou necessidade clara, pode atrapalhar o desempenho.
Um profissional não trabalha melhor porque tem cinquenta aplicativos abertos na tela. Ele trabalha melhor quando sabe qual ferramenta usar, em que momento usar e qual resultado precisa entregar.
O problema da “tool sprawl” Quando um agente recebe ferramentas demais, alguns problemas começam a aparecer:
- Ele pode escolher a ferramenta errada.
- Pode gastar tokens e chamadas desnecessárias.
- Pode seguir caminhos longos para resolver tarefas simples.
- Pode ficar indeciso entre opções parecidas.
- Pode produzir respostas mais lentas e menos previsíveis.
O resultado é um agente que parece mais poderoso, mas entrega menos.
A questão principal, portanto, não é:
“Quantas ferramentas o meu agente possui?”
A pergunta correta é:
“Quais ferramentas melhoram comprovadamente o resultado final?”
O teste que realmente importa
A forma mais confiável de responder a essa pergunta é testar o agente com tarefas reais. Funciona assim:
- Dê ao agente uma tarefa concreta e avalie o resultado final. Ele concluiu o trabalho? Foi preciso? Seguiu as regras? Evitou erros? Entregou no tempo esperado? Não avalie apenas o caminho percorrido. Um agente pode executar muitos passos e ainda assim entregar um resultado ruim. Da mesma forma, pode encontrar uma solução eficiente sem seguir exatamente o caminho que um humano imaginaria.
- Altere apenas um elemento. Adicione uma ferramenta, melhore o prompt ou forneça um contexto mais adequado.
- Execute a mesma tarefa novamente. Se a qualidade subir, a mudança provavelmente ajudou. Se continuar igual ou piorar, remova a alteração.
Esse processo transforma a construção de agentes em engenharia, não em tentativa e erro aleatória.
Observe as falhas, inclusive do avaliador.
Além de olhar o resultado, vale analisar o comportamento do agente:
- Onde ele se desviou?
- Em que momento desperdiçou chamadas?
- Qual ferramenta escolheu sem necessidade?
- Houve atraso causado por excesso de etapas?
- O problema estava no modelo, no contexto ou na tarefa?
Mas existe um detalhe importante: também é preciso avaliar o próprio sistema de avaliação. Se nenhuma configuração consegue ser aprovada, talvez o problema não esteja no agente. Pode estar na tarefa, nos critérios de avaliação ou no “gabarito” usado para medir o desempenho. Um avaliador ruim pode fazer um agente competente parecer incompetente.
A regra prática: Não adicione ferramentas porque elas parecem interessantes. Adicione uma ferramenta quando existir uma hipótese clara: “Esta ferramenta deve melhorar este resultado específico.”
Depois, teste. Se melhorar, mantenha. Se não melhorar, descarte. Se causar novos problemas, investigue antes de adicionar outra coisa. O melhor agente não é necessariamente o que possui mais recursos. É o que possui o conjunto certo de recursos, organizado para executar bem as tarefas que realmente importam.
Em agentes de IA, menos ferramentas podem significar menos ruído, menos custo, menos desvios e mais qualidade. A inteligência não está apenas no que o agente consegue fazer. Também está em saber o que ele não precisa fazer.
📌 Baseado em uma reflexão publicada em O Código/Super-humano e na abordagem de avaliação de harness apresentada pela Atlan e pelo projeto Better Harness, do PS LangChain.